Yuerer's Blog

钰儿的Blog

近期在改 Lua 5.4 的垃圾回收,虽然之前也写过分代垃圾回收的原理,但这次改完之后对其更有感悟,就简单记录一下Lua 5.4 的分代垃圾回收的实现原理。

简介

分代垃圾回收认为对象分为年轻代和老年代,其中年轻代对象很快就会被释放(比如临时对象),而老年代对象存在的时间比较长,不容易被释放,因此也就不需要经常去扫描老年代,只需要经常去扫描年轻代,等到年轻代垃圾回收的时候实在收不回对象,再进行一次全量垃圾回收。

原理

Lua 的 age 总共占用 3 Bit,刚创建出来的对象为 G_NEW ,当它活过一轮垃圾回收后,提升为 G_SURVIVAL ,若再活过一轮垃圾回收,则彻底进入 G_OLD 老年代,不在年轻代中扫描它。

1
2
3
4
5
6
7
8
#define G_NEW		0	/* created in current cycle */
#define G_SURVIVAL 1 /* created in previous cycle */
#define G_OLD0 2 /* marked old by frw. barrier in this cycle */
#define G_OLD1 3 /* first full cycle as old */
#define G_OLD 4 /* really old object (not to be visited) */
#define G_TOUCHED1 5 /* old object touched this cycle */
#define G_TOUCHED2 6 /* old object touched in previous cycle */
#define AGEBITS 7 /* all age bits (111) */

这里面的 G_OLD0 是用于 Barrier forward,假设你创建了一个新对象,它本该是 G_NEW 但因为它被老年代对象引用,所以必须要强行将它改为老年代,否则会发生跨代引用,该新对象直接被清理掉。

同理 G_TOUCHED1 则是用于 Barrier back,假设你创建了一个新对象,然后放置在一个老年代的 table中,此时为了不频繁触发该 table 的 barrier,则将其修改为 G_TOUCHED1 ,同时将其放置在 grayagain 链表中,这是因为老年代table是不会在年轻代的垃圾回收中被扫描到,但此时老年代又确实引用了年轻代对象,所以要将它放在一条特殊链表中,使其能在年轻代中被扫描到。
阅读全文 »

前言

Lua 开发者通常听说或使用过 LuaJIT,但是可能因为种种原因未能理解其工作原理,在这里分享一篇 Jakob Erlandsson 和 Simon Kärrman 的硕士毕业论文,TigerShrimp: An Understandable Tracing JIT Compiler,该论文讲述了如何为 JVM 开发一个 Tracing JIT,并附带了源码以及可视化工具。下文将简要剖析一些其实现原理。

编译流程

TigerShrimp 基于 JVM Bytecode,使用 Javac 将 Java 代码文件编译为 .class 文件,后直接进行 decode .class 文件,通过这种方式绕过 Parser 阶段,得到 bytecode。

执行流程

TigerShrimp 内部有个简单的 Interpreter,用以直接执行 bytecode,执行每一条 Instruction时,会记录当前的 pc (二元组,记录函数索引和指令索引,不然指令索引可能重复),是否为热路径,若为热路径,则会执行 record 流程,记录每一条执行的指令。(通常记录循环,循环有回边,记录执行次数,执行次数大于一阈值,则认为是热路径)。

若已经有 native code,即已经是热路径并完成了生成机器码的工作,则直接执行 native code。

阅读全文 »

背景

Lua 项目中,通常需要工具进行内存监控,目前开源的工具中有 lua-snapshot,但这个工具的缺陷是开销比较大,在调用接口之后,会扫描整个GC链表,找出所有的GC对象,并进行统计,最后会创建大量的 Lua 对象,将结果存在里面,这就会导致本身内存已经够高了,再用这个工具的话,很可能会触发 OOM 或者是 STW,业务无法正常提供服务。

作为补充,期望有个工具能够监控所有的对象开辟的位置和大小信息,进行精确定位代码问题。

最终实现的效果如下图所示:

阅读全文 »

剖析一下 CPython 的自动垃圾回收机制,并尝试提出改进的思路。

引用计数

相信有过计算机基础的人,哪怕对垃圾回收不那么熟悉,也肯定知道引用计数这个玩意。引用计数诞生于上个世纪,其主要思想是通过给每个对象增加计数,当计数为0时,则肯定没人使用该对象,可以放心将其删除。

虽然这个方法看起来有点糙,但在实际项目中,它的优点在于可以更实时的释放内存,释放内存的时机更精确,这也是为什么有的项目会尝试给 Lua 增添一个引用计数的垃圾回收,避免内存上涨过快。

凡事都有利弊,它的缺点也很明显,无法处理循环引用。

以下用 Python 举一个非常普遍的例子。

1
2
3
4
5
6
7
8
9
10
11
12
class A:  
pass

class B:
pass

a = A()
b = B()
a.b = b
b.a = a
del a
del b

在上面中,我们手动删除了 a 和 b ,理应进行释放,但由于 a 和 b 互相构成了循环引用,导致其引用计数总是不为0,进而造成内存泄漏,而 CPython 对其解决方法也极其简单,就是将所有可能造成循环引用的对象,构成一个双向链表进行扫描,从 root object 出发进行扫描 - 清除,无法到达的对象就是可释放的对象,普通的对象直接采用引用计数去释放,简单快捷。

怎么去验证以上结论呢?我们可以用反证法,当 del a 和 del b 后,再调用 gc.collect() 查看其是否能被回收到,如果能回收到,说明在此时引用计数已经失效。

1
2
3
4
5
6
7
8
# 设置 debug 标签,使得垃圾回收后的对象 存放至 gc.garbage 列表中
gc.set_debug(gc.DEBUG_SAVEALL)

# 回收第0代垃圾对象
gc.collect(0)

# 打印出回收的垃圾对象
print(gc.garbage)

可以看出引用计数确实失效了,因为通过 扫描-清除 回收能回收到这两个对象。

阅读全文 »

在上一篇关于 Python3 源码剖析中,剖析 float 的实现主要是阅读的 Python 3.10 的源码,但是在我看到 PEP-659 这篇关于指令特化(Specializing Adaptive Interpreter)的提案时,我就被它吸引了,因为这就是我之前想给 Lua 提速加的功能之一,冲着对它的热情,我决定将阅读的 CPython 版本提升到 3.11 ,这一篇就来剖析一下指令特化的实现,我们将通过两个对象做加法进行分析。

对象相加

首先通过 Python 自带的 dis 工具进行分析,分析两个对象相加的流程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
from dis import *
def test():
a = 1.5
c = a + 1.3
print(dis(test))

3 0 RESUME 0

4 2 LOAD_CONST 1 (1.5)
4 STORE_FAST 0 (a)

5 6 LOAD_FAST 0 (a)
8 LOAD_CONST 2 (1.3)
10 BINARY_OP 5 (*)
14 POP_TOP
16 LOAD_CONST 0 (None)
18 RETURN_VALUE

可以看到两个对象相乘的指令码为 BINARY_OP ,我们跟踪到 CPython 中,可以确定会调用到 PyNumber_Add 函数中。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
static const binaryfunc binary_ops[] = {
[NB_ADD] = PyNumber_Add,
[NB_AND] = PyNumber_And,
.....
};
TARGET(BINARY_OP) {
PREDICTED(BINARY_OP);
PyObject *rhs = POP();
PyObject *lhs = TOP();
PyObject *res = binary_ops[oparg](lhs, rhs);
Py_DECREF(lhs);
Py_DECREF(rhs);
SET_TOP(res);
if (res == NULL) {
goto error;
}
JUMPBY(INLINE_CACHE_ENTRIES_BINARY_OP);
DISPATCH();
}

PyNumber_Add 实现也很简单,先看看这两个对象支不支持该二元运算符,不支持,则看看支不支持 concat 操作。

阅读全文 »

去年 2021 年的时候,我的工作主要集中在改进 Lua虚拟机 ,后来由于工作变动,现在主要的工作语言已经切换为了 Python ,因此打算阅读下 Python 3.10 的源码,学习一下它的设计,对比 Lua 的优势。

希望在接下来的阅读过程中,能够体会到一种 回家 的畅快感。

本篇将以 float 作为起点,了解如何创建出一个浮点对象,深入剖析 float 其内部实现。

一切皆对象

一切皆对象 这句话都要被讲烂了,但是还要讲多一次。

Python 是一门面向对象的强类型动态语言,里面的任何东西都是对象,以浮点数为例。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
# a 是一个浮点实例对象,类型是 float
>>> a = 3.14159
>>> type(a)
<class 'float'>

# float 也是个对象,但它是 类型对象
>>> float
<class 'float'>
>>> float()
0.0

# float这个类型对象的类型是 type
>>> type(float)
<class 'type'>

以上我们可以确定,Python 中类型也是对象。

此外所有对象的类型都是 type ,可以称其为元类。而所有对象都继承自 object 。

阅读全文 »

截止至上一次发博文已经过了接近三个月时间,这么长的一段时间我主要是去做了以下几件事情,一个是实现 Lua 多线程的垃圾回收 方案,另一个则是 LuaJIT 5.3.6 实现。其实也没用到三个月,实现代码加上测试一共花了一个月。

Lua 多线程垃圾回收

这一块的思路主要是从 Redis 通过子线程释放内存这块学来的,通过这个小优化,使得我们游戏服务器在大量玩家下线时,不再出现大规模的掉帧,效果还是非常显著的。

LuaJIT 5.3.6

之所以实现这个 Lua 5.3.6 JIT,其实是因为 LuaJIT 2.0 不支持 5.3的新扩展,而项目已经进行到了中后期,没有时间去调整代码了,最后花了半个月的时间去实现了一个小版本,通过了 Lua 的官方测试用例,也在项目用上了。性能方面提高了2-5倍,接入成本为0,不需要修改任何逻辑代码。

至于解释器部分,借鉴了 Lua 5.4 的一个小优化点,将 switch case 修改为了 computed goto ,提升了约 5% 的性能,之后可能会学习 Lua 5.4 扩展字节码。如果这个项目还做下去的话(我有时间的话),我会想尝试解释器执行脚本时记录各个操作数的类型,实现动态替换字节码,减少不必要的类型判断,从而提升一定的解释器速度。不过这个方案风险太大,暂时先搁置。

在实现 LuaJIT 5.3.6 的过程中,顺带复习了一下编译原理的前端部分,实现了一些官方不支持的语法,比如 ‘+=’,自增表达式(当然没有提交),还是非常有趣的。

结语

以上的代码实现已经开源,合并之前的 NOGC 优化思路,LuaJIT-5.3.6,欢迎 Star ,这对我很重要。

阅读全文 »

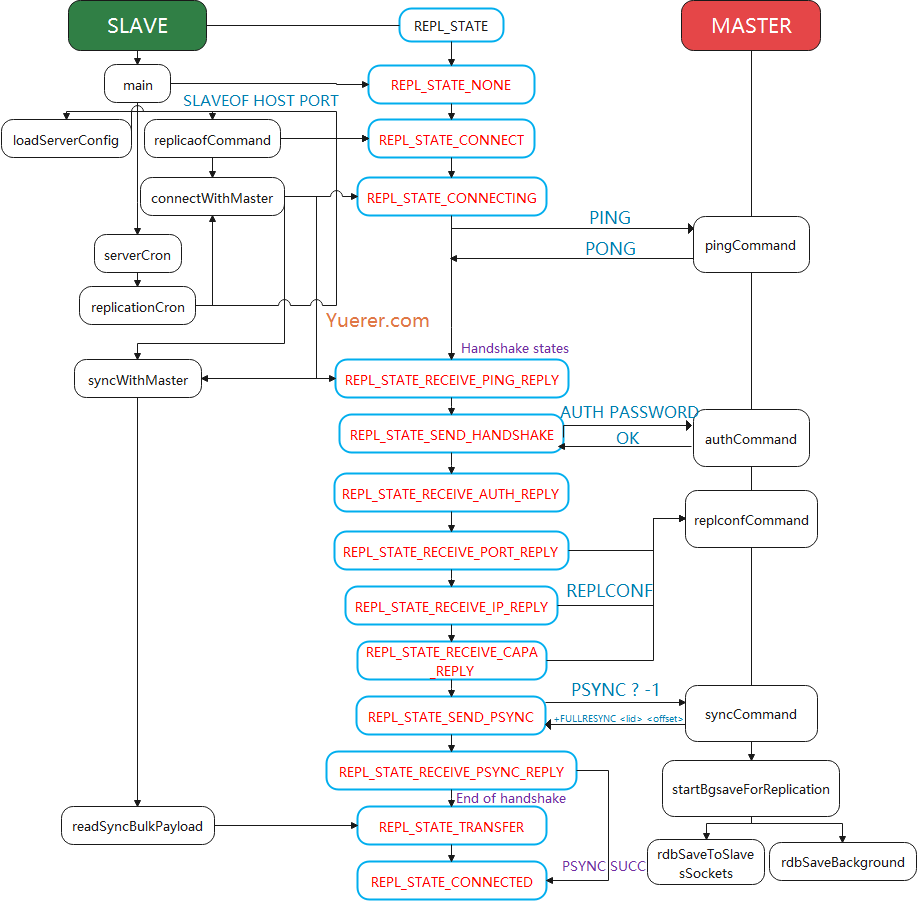
本篇是 Redis 6 剖析的第二篇,主要探讨 Redis 是怎么做主从同步的,对代码会有所删减。

SLAVE

通常启用主从同步,只要在从服务器执行 SLAVEOF HOST PORT 即可,这个时候就会执行到 replicaofCommand 。由于主从同步是从服务器发起的,因此我们先从 Slave 开始进行剖析。

Redis6-Replication

阅读全文 »

一直觉得关系型数据库非常难用,在使用之前要先定好表的结构,中途修改存储结构,改动就会非常繁杂,特别是 外键 这玩意离开了学校就再也没见过。好在在 游戏领域 中,用的最多的都是 NoSQL 。

熟悉我风格的人,可以看出这个系列的标题,不再是 源码剖析,而是只有 剖析 两字,主要是考虑到 Redis 6.0 的代码量已经挺大了,同时网络中又有大量关于 Redis 数据结构的源码剖析,没必要再炒冷饭了。

出于以上的原因,我将 Redis 分为几个部分进行剖析和讨论。

  1. 异步机制
  2. 主从同步
  3. 集群
  4. 数据结构

本篇主要是来剖析 Redis 为了避免 阻塞 ,是如何运用 多进程 与 多线程,这两种异步机制的。

阻塞点

Redis 一般有以下几种阻塞的点。

从网络交互来看有

  • 网络 I/O (多线程)
  • 客户端交互 (部分删除用多线程 BIO)
  • 传输 RDB 快照 (多进程)

从磁盘交互又分

  • 关闭文件 (多线程 BIO)
  • 记录 AOF 日志 (多线程 BIO)
  • AOF 日志重写 (多进程)
  • RDB 快照生成 (多进程)
阅读全文 »

前篇解析了 Gossip 协议,这篇主要看看 Raft 是如何实现的。

本文主要分为两个部分,首先是粗略讲解一遍 Raft 的设计思想,在这一部分不会将 RPC 的各种字段(因为没有意义,只会徒增心智负担),而在第二部分则是通过解析一份优质的 Raft 源码实现,在这个部分再深入到 RPC 各个字段。

如果看了一遍看不懂也没关系,建议多去看看 Raft 的论文,笔者也是反复看了两周才大致理解其指导思想。

Raft

一提到共识算法,相信大部分人都能马上想到 Paxos,但是我认为它不是算法,它的论文里面顶多算是一个指导思想,很少有人能够读完它就实现出一个可靠的共识算法(关键是要验证其的正确性),但是 Raft 不一样,它的一些设计非常巧妙,能够令人非常好的理解其指导思想,同时比较容易的实现(因为 Raft 从诞生那一刻就是为了弥补 Paxos 的可理解性,看看人家的论文名字 In Search of an Understandable Consensus Algorithm 可理解的分布式共识算法)。

用过 Zookeeper 的可能知道其内部的协议就是根据 Paxos 的指导实现的一个 Zab 算法,之所以不用 Raft 是因为 Raft 那时候还没出世呢。

阅读全文 »
0%